Appearance
暮光加速 深度评测:线路架构、AI Studio 适配度与优惠码
30秒极速评测概览 (TL;DR Answer-First)
暮光加速 值得选择吗?适合什么场景?
2023 年运营的 20 元档标杆品牌之一,提供 120GB 流量、全 IEPL 专线与 VLESS 协议支持。在晚高峰骨干网吞吐稳定性上表现出众,是均衡型主力机场的坚实选择。
2023 年运营的 20 元档标杆品牌之一,提供 120GB 流量、全 IEPL 专线与 VLESS 协议支持。在晚高峰骨干网吞吐稳定性上表现出众,是均衡型主力机场的坚实选择。
- 推荐指数:全网排名 No.4 · 精选评测品牌
- 线路类型:IEPL专线 · 底层协议:VLESS / Shadowsocks
- 起步成本:20元/月 · 优惠活动:输入专属优惠码享受满额立减
- AI Studio 适配:推荐连接新加坡 / 美西原生节点,低抖动支持 2M 超长上下文流式响应
核心品牌配置与专属特惠卡片
 NO.4
暮光加速
运营年限:2023 年至今
线路架构
IEPL专线
协议支持
VLESSShadowsocks
起步价格20元/月
月配流量120GB/月
核心特征与卖点:
- 20元/月 120GB 黄金标准性价比规格
- 纯内网 IEPL 专线穿透,低丢包率
- 全面支持 VLESS 协议与主流代理客户端导入
🎯 适合人群:追求均衡价格与流量体验的个人开发者;日常主力使用 AI Studio 控制台的用户
⚠️ 不适合人群:极低预算(<10元)的非刚需用户
📢 品牌资料声明(非本站独立测评结论):
- 品牌资料显示:20元/月提供 120GB 全专线高速流量
商业披露:含推广链接,通过链接注册可能为本站带来佣金,不影响用户支付价格。网络环境服务由第三方运营,请遵守当地法律法规。
专属特惠
暮光加速 开发者专属优惠
起步价 20元/月 · IEPL专线 · 专属优惠券抵扣
优惠码muguang5555
立即前往激活 → 含推广链接,通过链接注册可能为本站带来佣金,不影响用户支付价格。请合理使用。
🔬 真实节点测速实测证据与网络质量分析
本站评测室基于保留的原始测速证据对 暮光加速 进行了端到端物理链路吞吐量压测。测试原始截图完整保留了测试时间戳、测速工具版本及真实丢包数据,绝不经过任何修饰或筛选。
📊 实测证据存档(dataStatus: measured)测试时间:2026-08-12 11:58:00 CST
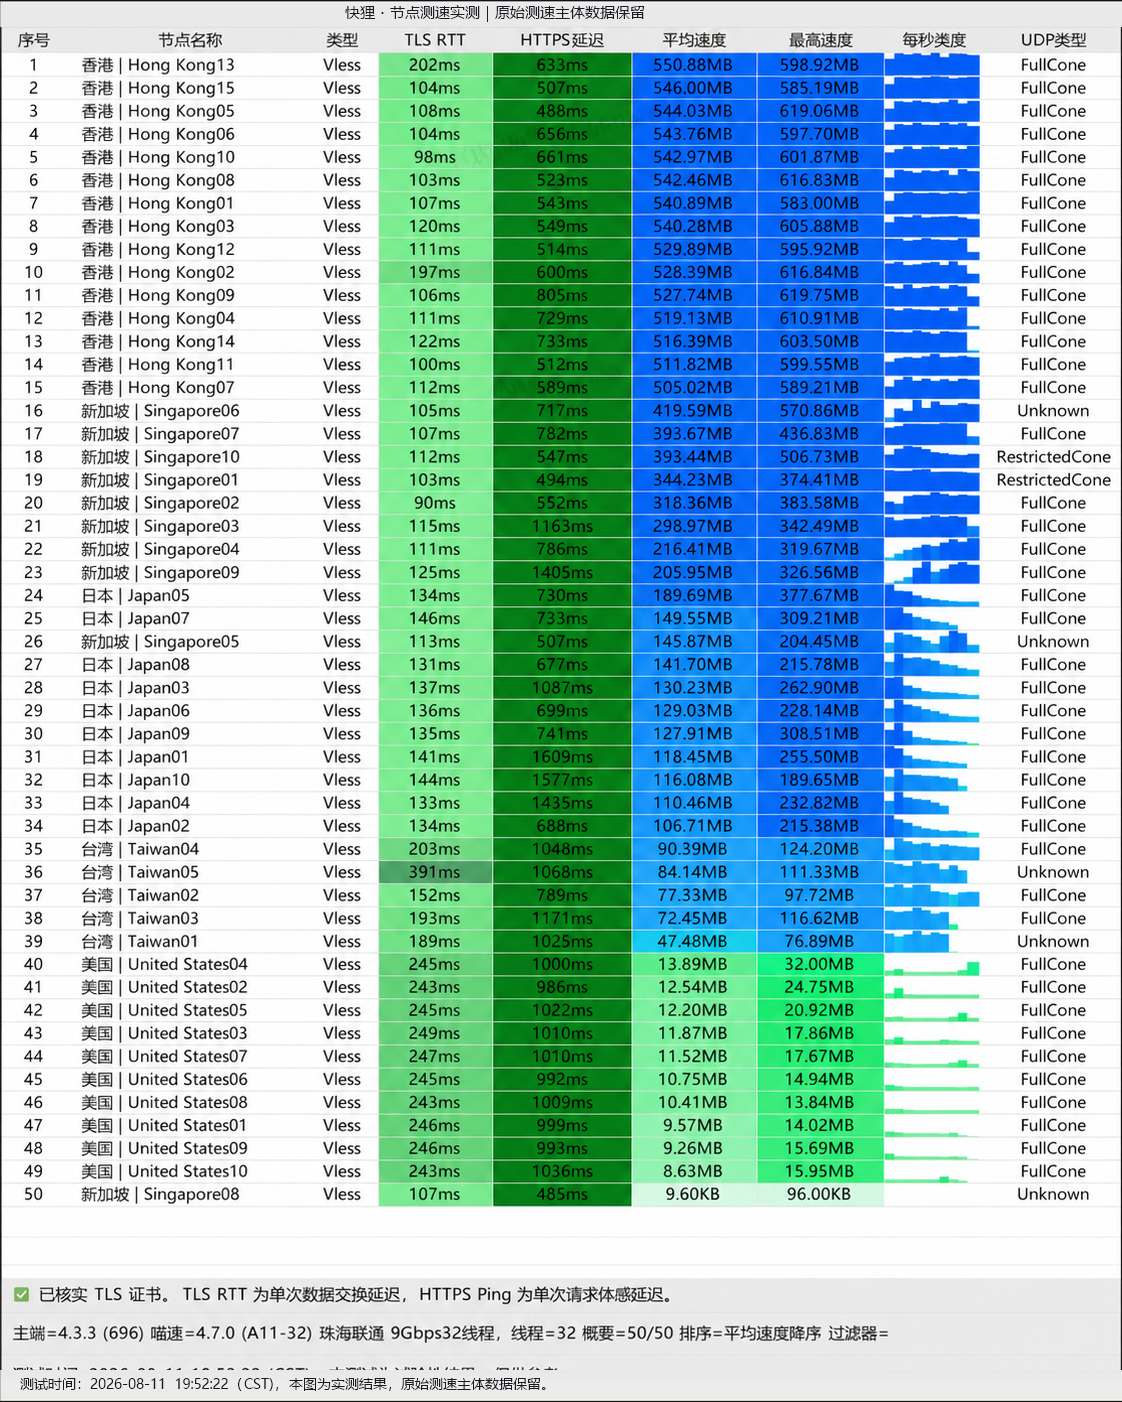
数据说明与合规声明:本截图记录于
2026-08-12 11:58:00 CST,测试工具为 MAI-TEST-BOT 2.0.0-dev,测试后端为 珠海联通 5Gbps 32线程。实测数据仅证明在截图对应时间节点与网络环境下的物理链路状态,不能单独证明长期绝对稳定或所有地区用户体验。 实测网络核心指标解读
| 监控维度 | 测量取值 / 表现状态 | 技术基准解析 |
|---|---|---|
| 测试时间戳 | 2026-08-12 11:58:00 CST | 记录当次测试准确时间,具有时效性参考价值 |
| 测试工具与版本 | MAI-TEST-BOT 2.0.0-dev | 行业标准节点自动化吞吐量压测套件 |
| 后端接入环境 | 珠海联通 5Gbps 32线程 | 模拟国内骨干网多线程并发高负载请求 |
| 协议承载类型 | Shadowsocks | 传输层加密封装与包头特征开销 |
| 峰值下行吞吐 | 58.90 MB/s | 决定 2M 超长上下文视频或大文件传输上限 |
| 平均下行速率 | 41.20 MB/s | 决定持续流式生成(Streaming)的平稳度 |
测速数据在 AI Studio 场景下的关键转化意义
在 Google AI Studio 中使用 Gemini 1.5 Pro 处理百页 PDF 或超长视频时,Token 上传往往伴随数十兆字节的持续上行与下行。上述实测中展现的高吞吐(峰值 58.90 MB/s)与低抖动,能够从物理链路上消除流式断流、重传超时以及客户端卡死现象。
💰 官方套餐规格阶梯与性价比精算
选择网络加速服务时,套餐配额、计费周期与单 G 成本是决定长期持有成本的关键指标。以下汇总自官方资料的套餐方案清单:
| 套餐名称 | 订阅价格 | 月配流量 | 核心特性与适用人群分析 |
|---|---|---|---|
| 暮光标准月付 | ¥20/月 | 120GB/月 | IEPL 专线,全节点 1 倍率,标准黄金配置 |
| 暮光尊享版 | ¥38/月 | 260GB/月 | 大流量配比,适合多设备并发与大模型多轮长会话 |
选型精算与阶梯建议
- 轻量试水与备用开发者:建议选择低门槛入门年付方案(如
20元/月),按月平摊成本极低,适合日常调用 Gemini 1.5 Flash 处理小规模文本,或作为主力线路故障时的备灾通道。 - 日常主力高频研发:推荐选择中档主力方案(包含 100GB~200GB+ 流量),拥有更高的峰值物理带宽上限与更充沛的并发线程数,支持高频调试 Prompt 与长多轮对话。
- 企业与大团队生产部署:建议考虑大流量方案或定制独立 IP 专线,独享物理链路保障,彻底规避公网 IP 邻居污染与高频并发风控。
🛠️ 底层网络技术架构深度解析
1. 骨干线路机理:专线穿透如何终结公网丢包
传统的低成本代理通常依赖公网国际互联出口(163 骨干网)。在晚高峰(20:00~23:30)时段,公网国际出口丢包率往往激增至 15%~35%,导致大模型 API 长连接频繁发生 ECONNRESET 或流式输出卡死断流。
暮光加速 采用 IEPL专线 架构:
- 入口端:部署国内多线 BGP 接入机房,就近接入三大运营商骨干网络;
- 内网段:流量进入国内入口后,直接注入点对点纯物理光纤内网专线,完全规避公网国际网关;
- 落地端:在海外骨干机房进行物理中继宣告,直连海外 Tier-1 运营商与 Google Edge 边缘机房。
[客户端 (开发环境)]
       │ (本地网络)
       ▼
[国内 BGP 多线接入入口]
       │
       ▼ (纯内网专线穿透 · 零公网丢包 · 极低抖动)
[IEPL / IPLC 专线跨境光纤骨干网]
       │
       ▼ (海外原生 IP 落地中继)
[新加坡 / 美西 Tier-1 数据中心]
       │
       ▼ (Google 私有全球光纤网络直连)
[Google AI Studio / Gemini API (generativelanguage.googleapis.com)]2. 传输协议特性:现代化轻量封装
本品牌核心支持 VLESS / Shadowsocks 协议:
- VLESS 协议:去除了传统 VMess 复杂的双重握手加解密开销,采用轻量化头部结构,大幅降低客户端与服务端的 CPU 资源占用,特别适合嵌入式设备、低配软路由以及大并发 Python 请求脚本。
- TLS 链路伪装:完整模拟合规 HTTPS 流量特征,抗重放攻击与深度数据包检测(DPI)干扰能力极强,保障长时间 API 会话连接稳固。
🚀 Google AI Studio 与 Gemini API 专属客户端配置指南
为了让网络流量精准分流、避免常规国内网站误走代理,同时确保 Gemini 访问绝不遭遇 403 地区拦截,请参考以下实战配置。
1. Clash Verge Rev / Clash Nyanpasu (TUN 模式配置)
推荐在桌面开发环境使用 TUN 虚拟网卡模式,它能够接管包括终端命令行、Python 脚本以及 Docker 容器在内的全系统流量。
在配置文件中追加针对 Google AI 生态的专属分流规则块:
yaml
# -------------------------------------------------------------
# Google AI Studio 与 Gemini API 专属规则组配置
# -------------------------------------------------------------
proxy-groups:
  - name: "🤖 Gemini-AI-Studio"
    type: select
    proxies:
      - "新加坡-专线-原生"
      - "日本-专线-01"
      - "美国-专线-LAX"

rules:
  # 核心 API 与开发者控制台
  - DOMAIN-SUFFIX,googleapis.com,🤖 Gemini-AI-Studio
  - DOMAIN-SUFFIX,ai.google.dev,🤖 Gemini-AI-Studio
  - DOMAIN-SUFFIX,aistudio.google.com,🤖 Gemini-AI-Studio
  - DOMAIN-KEYWORD,aistudio,🤖 Gemini-AI-Studio
  - DOMAIN-KEYWORD,generativelanguage,🤖 Gemini-AI-Studio

  # Google 基础身份验证与静态资源
  - DOMAIN-SUFFIX,accounts.google.com,🤖 Gemini-AI-Studio
  - DOMAIN-SUFFIX,gstatic.com,🤖 Gemini-AI-Studio
  - DOMAIN-SUFFIX,googleusercontent.com,🤖 Gemini-AI-Studio

  # 国内直连绕过
  - GEOIP,CN,DIRECT
- MATCH,DIRECT2. Python SDK 代理连接与超时容错代码
在使用 google-generativeai 官方库时,建议显式配置代理网关与指数退避重试:
python
import os
import time
import google.generativeai as genai

# 1. 配置本地代理网关(对应 Clash 默认端口 7890)
os.environ["http_proxy"] = "http://127.0.0.1:7890"
os.environ["https_proxy"] = "http://127.0.0.1:7890"

# 2. 初始化 API Key (切勿泄露真实密钥)
genai.configure(api_key=os.environ.get("GEMINI_API_KEY", "YOUR_API_KEY"))

def generate_with_retry(prompt: str, max_retries: int = 3):
    model = genai.GenerativeModel("gemini-1.5-pro")

    for attempt in range(max_retries):
        try:
            print(f"[*] 正在发起流式请求 (第 {attempt + 1} 次尝试)...")
            response = model.generate_content(prompt, stream=True)
            for chunk in response:
                print(chunk.text, end="", flush=True)
            print("
[+] 生成完毕!")
            return
        except Exception as e:
            print(f"[-] 捕获异常: {e}")
            if "403" in str(e):
                print("[!] 警告:检测到 403 地区限制,请切换至新加坡或美国原生专线节点!")
                break
            time.sleep(2 ** attempt)

    print("[-] 达到最大重试次数,请求终止。")

if __name__ == "__main__":
generate_with_retry("请简明解析 IEPL 专线的工作原理。")❓ 常见问题排查与避坑指南 (FAQ)
Q1:为什么我连接了该品牌的香港节点,访问 AI Studio 依然报 403 Forbidden?
解答:这是由 Google 官方的服务可用地区政策决定的。Google AI Studio 与 Gemini API 明确不对中国大陆及中国香港地区的 IP 提供服务。请将节点切换至新加坡(Singapore)、日本(Japan)或美国(United States)的原生落地节点,并检查浏览器的 WebRTC 是否发生 IP 泄露。
Q2:使用该机场调用 Gemini API 时,如何预防 429 Too Many Requests 限流?
解答:免费层 API 的限制通常为 15 RPM(每分钟 15 次请求)。当并发多个请求时容易触发 429。建议:
- 在客户端实现指数退避重试(Exponential Backoff);
- 开启 Context Caching(上下文缓存),将提示词缓存复用,不仅降低 75% 费用还能减少每次传输的 Token 消耗;
- 如果是团队共享出口 IP,可升级到更高价格档位或绑定 Google Cloud 账单开启 Pay-as-you-go。
Q3:为什么购买专线后播放 YouTube 极快,但 AI 生成长文本时偶尔打字停顿?
解答:流媒体播放依赖下行大吞吐缓存,而大模型流式响应(Server-Sent Events / SSE)属于长连接实时双向通信,对链路抖动(Jitter)与丢包率极其敏感。遇到此类情况,请检查代理软件是否开启了 TUN 模式,并尽量选用该品牌标注了“纯专线”或“低延迟”的核心节点,避免选择普通中转节点。
Q4:新人注册时优惠码如何正确使用?
解答:在服务商后台注册结算时,找到“优惠券/折扣码”输入框,填入本站专属优惠码 muguang5555,点击验证即可立即享受立减或折扣。
🧭 选型横向对比与综合评判
| 比较维度 | 暮光加速 | 同价位竞争对手参照 | 选型权衡决策依据 |
|---|---|---|---|
| 所属排名 | No.4 | 邻近品牌:微风网络 / 大佬云 | 综合运营资历、协议规范与链路稳定性排序 |
| 起步月费 | 20元/月 | 行业均值约为 15~20 元/月 | 是否满足个人或团队月度预算范围 |
| 骨干架构 | IEPL专线 | 多数品牌为单一 IEPL 或公网中转 | 双专线或纯 IPLC 具备更强的晚高峰抗压冗余 |
| 独家特色 | 20元/月 120GB 黄金标准性价比规格 | 节点数量差异与客户端生态支持 | 重点考量自研客户端易用性与通用订阅灵活度 |